Data & IA · 14/08/2026
Tous les IoT se valent-ils ? Explorations statistiques sur 2 compteurs
En 2 phrases. J’ai posé 2 compteurs électriques triphasés au TGBT d’un petit local bureau et laissé tourner 10 jours pour voir s’ils étaient équivalents. Après quelques tests statistiques et quelques visualisations, j’ai une meilleure vision des points communs et des différences pour ces capteurs.
J’ai enregistré 59 040 points par appareil, échantillonnés au pas 15 secondes. J’appelle le premier Compteur D., la référence haute fidélité. Le second, Compteur S., un compteur filtré : il progresse en escalier et lit un peu plus bas.
1. Les signaux bruts ont l’air identiques de loin
La première étape, c’est une exploration visuelle. Sur 10 jours, les 2 courbes se superposent presque parfaitement : même forme, mêmes pics et mêmes creux. Un œil pressé conclurait à l’équivalence des 2 compteurs. D’ailleurs c’est ce que j’ai failli faire en me disant “close enough” en regardant les historiques sur notre GTB.
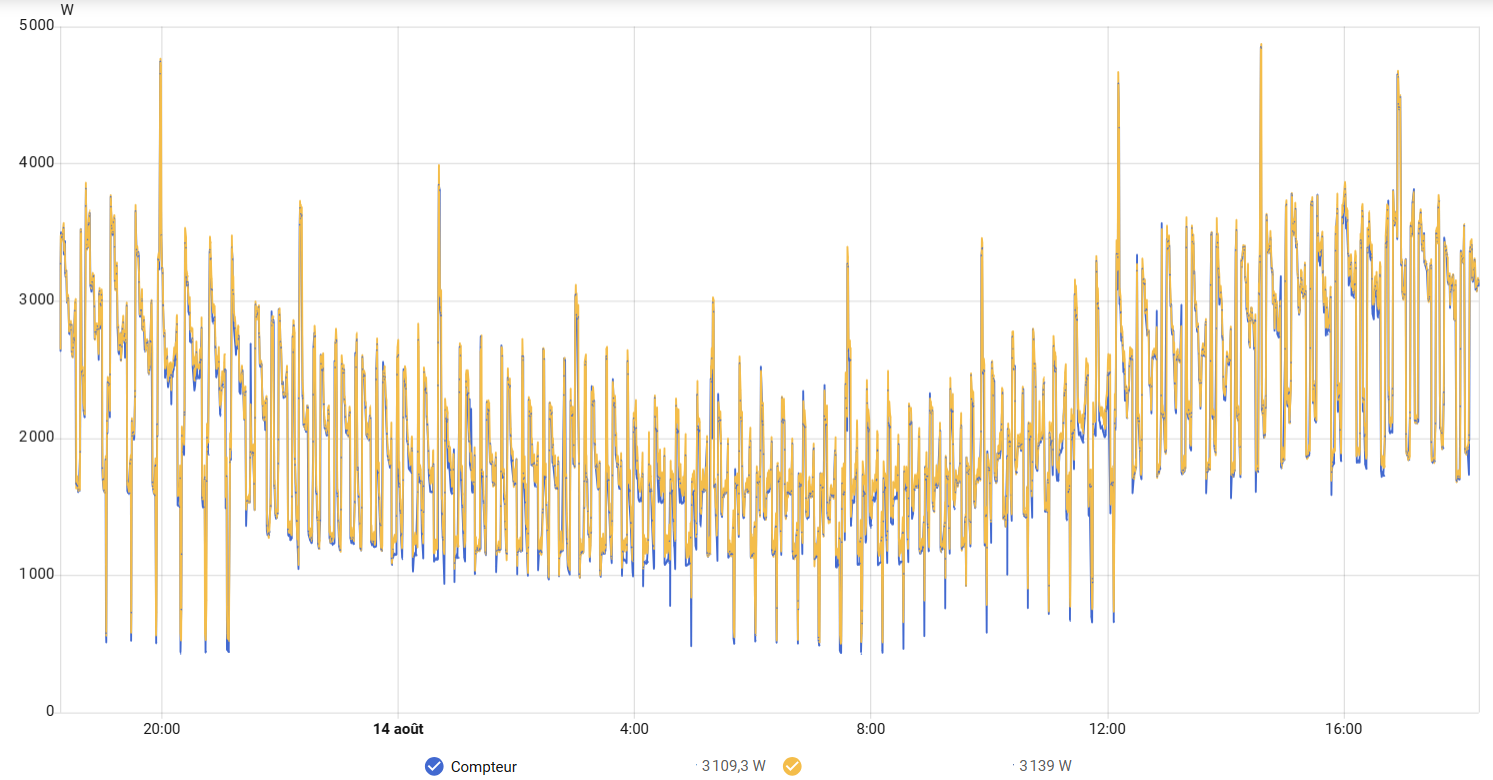
Mais j’aurais eu tort, avec un premier indice en bas : le total cumulé n’est pas exactement le même. En zoomant sur une fenêtre de trois heures, la différence saute aux yeux. Le Compteur D. (jaune) suit la charge en continu, avec la finesse d’un signal analogique. Le Compteur S. (bleu) avance par paliers : il tient une valeur, puis saute à la suivante, comme un escalier. Je n’étais pas sûr : bruit de mesure ou finesse supplémentaire ?
Toute la suite m’a servi à répondre à cette question.
Puissance appelée · vue d'ensemble
cliquer et glisser pour zoomer · double-clic pour réinitialiserZoom · une fenêtre de 3 heures
le S. monte en marches, le D. est lisse2. 53% de l’énergie est consommée par des cycles lents
Le signal de puissance porte des rythmes : le cycle d’occupation du bâtiment, les habitudes d’usage, le bruit de mesure. La transformée de Fourier rapide (FFT) sépare ces rythmes selon leur fréquence.
FFT
Pour les 2 compteurs, un pic net apparaît au cycle journalier (1 par jour), signature de l’occupation du local. Autre information : 53 % de l’énergie du signal se trouve dans les cycles plus lents qu’une journée. La majorité de ce qui change dans les données change de façon plus lente que ça.
Aux fréquences basses, les 2 spectres sont quasi superposables : les compteurs racontent la même chose. La divergence se cache dans le tiers restant, aux fréquences élevées.
Densité d'énergie (Compteur D.)
cliquer et glisser pour choisir une bande · double-clic pour réinitialiserSpectre d'amplitude · les points hors bande sont estompés
3. Le compteur S. gomme ses micro-variations
Comparer 2 signaux sur leur valeur brute est un piège classique. 2 signaux peuvent avoir la même moyenne, la même variance globale, et se comporter de façon complètement différente d’un instant à l’autre. Il faut donc aussi comparer leurs incréments : la variation d’un pas de 15 secondes au suivant (ΔP).
Sur les signaux bruts, un test de Levene donne F = 0,47, p = 0,49. Ça ne permet pas de rejeter l’hypothèse d’égalité des variances. Les 2 compteurs semblent avoir la même dispersion globale.
Levene
Si on creuse sur les incréments, tout change. Le même test donne F = 1718, p ≈ 0, et donc un rejet net. La variation médiane pas à pas est de 4,9 W pour le Compteur S., contre 34,0 W pour le Compteur D., soit un rapport 7.
Un F-test appliqué directement aux incréments confirme l’ampleur de la différence : le S. ne conserve que 78 % de la variance haute fréquence du D., soit environ 22 % de variance en moins.
Le signal brut et ses incréments racontent 2 histoires différentes. Comparer 2 capteurs sur leurs valeurs seules peut masquer un filtrage complet de la dynamique fine. Toujours tester les 2 niveaux.
Ce comportement a un nom : un deadband (ou bande morte) du firmware. Sous un certain seuil de variation, le Compteur S. ne met pas à jour l’information et n’envoie rien de nouveau à la GTB. Avec un seuil de ±10 W, 72 % des variations du S. tombent sous ce seuil, contre 17 % pour le D. C’est ce mécanisme qui produit l’escalier observé en section 1 pour le compteur S. et pas pour le compteur D..
deadband
C’est aussi la première nuance statistique à ne pas rater : Ne pas rejeter H0 sur le signal brut (p = 0,49) ne prouve pas que les 2 compteurs se comportent pareil. Ça veut simplement dire que les données ne suffisent pas à contredire cette hypothèse, à ce niveau d’analyse précis. D’ailleurs il a bien fallu descendre au niveau des incréments pour voir la vraie différence.
Distribution des variations d'un pas au suivant (15 s)
déplacez le seuil4. L’analyse révèle aussi un enjeu de calibration avec un écart constant de 66 W
Le test de Bland-Altman répond à une question précise : les 2 sources de données sont-elles interchangeables, et si non, l’écart dépend-il de la valeur ?
Bland-Altman
Le résultat central : le Compteur S. lit en moyenne 66 W de moins que le Compteur D. Les limites d’agrément à 95 % du test s’étendent de −207 W à +74 W (d’où -66 W en moyenne).
limites d'agrément (LOA)
La forme du biais est aussi importante. Le nuage de points reste plat sur toute la plage de puissance : la pente de la régression du biais contre la puissance moyenne n’est que de 0,4%. En découpant les données par tranche de puissance, le biais reste stable, entre -56 et -71 W selon la tranche.
| Tranche de puissance | Biais moyen (S. − D.) |
|---|---|
| Basse | proche de −56 W |
| Médiane | proche de −66 W |
| Haute | proche de −71 W |
Cette pente de 0,4% est statistiquement significative (p ≈ 1e-85, avec 59 040 points le test a une puissance considérable). D’où la 2e nuance que je signale (on voit ça tout le temps dans les études en nutrition…) : significatif ne veut pas dire important ; toujours regarder le fameux effect size. Une pente de 0,4% ne déplace le biais que d’environ 12 W sur toute l’amplitude de puissance observée (environ 3000 W). Le biais reste peu ou prou constant sur la plage de fonctionnement. Pas la peine de compliquer le correctif, on peut faire une calibration avec une valeur constante (à déterminer réellement avec un outil de métrologie certifié).
Écart S − D selon la puissance moyenne
cliquer et glisser pour choisir une tranche · double-clic pour tout revoirNote : la pente du biais (0,004 W/W) est statistiquement significative (p ≈ 10⁻⁸⁵, à cause des 59 040 points) mais négligeable en pratique : sur 3 000 W d'amplitude, elle ne déplace le biais que de ~12 W. Significatif n'est pas synonyme d'important.
5. Les compteurs ont une synchronisation quasi parfaite
Ça se voyait globalement sur les courbes, mais on peut également vérifier que nos 2 séries temporelles ne sont pas décalées. Un capteur qui échantillonne avec 2 minutes de retard produirait des écarts qui n’ont rien à voir avec un problème de mesure.
La cross-corrélation fait glisser un signal sur l’autre et cherche le décalage (lag) qui maximise leur ressemblance. Ici, le pic tombe exactement à lag = 0 seconde, avec une corrélation de 99%. Traduction : les signaux se ressemblent le plus quand ils sont décalés de 0s l’un par rapport à l’autre (à la fréquence d’échantillonnage près de 15s). Ouf, rien à décaler avant de poursuivre l’analyse.
Corrélation selon le décalage temporel
cliquer et glisser pour zoomer6. La cohérence spectrale fond pour des variations sous les 10 minutes
La cohérence spectrale répond à une question que le test de Bland-Altman ne pose pas : à partir de quelle vitesse de variation les 2 compteurs cessent de raconter la même chose ? (Spectre = ce qui se passe en fonction des fréquences).
cohérence spectrale
Aux fréquences lentes, au-delà d’une variation horaire, la cohérence dépasse 99%, donc quasi parfaite. Au-delà d’un cycle par 10 minutes, elle s’effondre vers environ 50%. Les 2 signaux deviennent statistiquement indépendants sur les variations plus rapides que la dizaine de minutes.
Ça confirme directement la section 3 : le deadband du Compteur S. brouille les détails rapides. Il introduit aussi un léger retard structurel, visible dans un déphasage d’environ −26° aux fréquences hautes : le S. ne fait pas que lisser, il met à jour ses valeurs avec du retard sur les variations rapides.
La cohérence spectrale permet d’obtenir une information que les autres tests ne donnent pas directement : une fréquence de coupure. En dessous de 1 cycle par 10 minutes, faire confiance aux 2 compteurs de façon interchangeable est justifié. Au-delà, non.
Cohérence spectrale · par fréquence
cliquer et glisser pour zoomer7. Un écart d’énergie de 6,2% sur 10 jours, parfaitement linéaire dans le temps
L’intégration de la puissance dans le temps donne l’énergie. Sur 10 jours : 246 kWh pour le Compteur S., 262 kWh pour le Compteur D., soit un écart de 6,2%.
Cet écart n’est pas surprenant compte tenu du biais constant identifié en section 4 : un biais de 66 W, intégré sur 10 jours, produit mécaniquement un déficit d’énergie proportionnel à la durée. La dérive cumulée de l’écart suit une droite quasi parfaite (R² = 99,9%), sans accélération ni ralentissement dans le temps. L’écart se répète, jour après jour, à l’identique.
C’est la ligne 8 du tableau de synthèse (section suivante) : on ne rejette pas l’hypothèse d’une dérive stable dans le temps. Cette formulation n’est pas un test d’hypothèse formel avec p-value, c’est juste une comparaison de modèles (droite vs courbe). La droite explique 99,9 % de la variance de l’écart cumulé, ce qui ne laisse pas vraiment de place à une dérive additionnelle.
Pour un usage réglementaire (déclaration décret tertiaire, plateforme OPERAT), 16 kWh d’écart sur 10 jours ne sont pas négligeables sur une année. Encore une fois, ça représente 6% de la consommation de ces locaux en période estivale ; ça peut représenter quelques % sur l’année qui font passer ou pas la barre des objectifs 2030 du décret tertiaire. C’est potentiellement un budget travaux de quelques k€ évité. Le choix des IoT n’est donc pas anodin.
OPERAT
Énergie cumulée · et écart résiduel après correction
cliquer et glisser pour zoomerÉnergie quotidienne · les deux compteurs, jour par jour
l'écart absolu se répète, sans dérive8. L’équivalence entre les compteurs est vérifiée au global (R² = 98%) mais s’effondre sous 500 W
La régression linéaire donne : S = 0,995 × D − 61 W, avec R² = 98%. La pente proche de 1 confirme qu’il n’y a pas d’erreur de gain entre les 2 compteurs. L’ordonnée à l’origine retrouve, à peu près, le biais déjà identifié en Bland-Altman. Un terme quadratique ajouté au modèle n’apporte rien de mesurable : la relation est linéaire, pas besoin de complexifier.
Peut-on s’arrêter là ? 2 réserves :
- une hétéroscédasticité nette : le test de Breusch-Pagan rejette l’hypothèse de résidus à variance constante (p ≈ 0). Concrètement, l’écart-type des résidus double entre le bas et le haut de la plage de puissance. Le modèle est moins précis en haute charge.
- en découpant la régression par tranche de puissance, le R² s’effondre à 4% sous 500 W, contre 98% sur le reste de la plage. Dans cette zone basse, le nuage de points devient rond : connaître la valeur du Compteur D. ne dit presque plus rien de celle du Compteur S. Les 2 cessent de bouger ensemble.
hétéroscédasticité
Un R² global de 98% sur l’ensemble des données peut donc coexister avec un lien pratiquement nul sur une portion entière de la plage. La régression globale ment par omission si l’on ne va pas vérifier les résidus, tranche par tranche. Le diable est dans les queues de distribution…
Compteur S. en fonction du Compteur D.
cliquer et glisser pour zoomerÀ quel point le Compteur D. prédit le Compteur S., par tranche de puissance
R² = 1 : le D. prédit parfaitement le S. R² proche de 0 : la tranche est du bruit, les deux ne se suivent plus.
Annexe statistique avec les 11 hypothèses testées et les résultats
Règle pour l’ensemble du tableau ci-dessous sauf mention contraire : seuil α = 0,05, on rejette H0 si la p-value passe sous ce seuil.
Je rappelle 2 choses pour la colonne de décision :
- Ne pas rejeter H0 n’est pas prouver H0. Avec 59 040 points de mesure, un test non rejeté (lignes 1 et 8) est un signal fort d’absence d’effet visible à ce niveau d’analyse. Ça reste une absence de preuve, pas une preuve d’absence.
- Significatif ne veut pas dire important. La ligne 5 par exemple avec une pente de 0,4%, significative à p ≈ 1e-85 avec cette taille d’échantillon. Mais elle ne déplace le biais que de 12 W sur 3000 W d’amplitude. Une décision de rejet doit toujours se lire avec la grandeur mesurée et l’enjeu, pas seule.
Les lignes 6, 8 et 9 ne portent pas de p-value : ce sont des estimations ou des comparaisons de modèles (pic de corrélation à lag 0, dérive linéaire contre courbe, gain quadratique nul), pas des tests formels.
Chiffres clés, en un tableau
| Fait | Valeur |
|---|---|
| Durée d’observation | 10 jours (4 au 14 août 2026) |
| Points par compteur | 59 040 (rééchantillonnés à 15 s) |
| Énergie dans les cycles > 24 h | 53% |
| Variation médiane pas-à-pas | 4,9 W (S.) contre 34,0 W (D.), facteur 7 |
| Biais Bland-Altman | -66 W |
| Limites d’agrément 95 % | [-207, +74] W |
| Décalage temporel | 0 s (corr. 99%) |
| Cohérence au-delà de 1/10min | ≈ 0,50 |
| Énergie sur 10 j | S. 246 kWh, D. 262 kWh (-6,2%) |
| Régression | S = 0,995 × D − 61 W, R² = 0,98 |
| R² sous 500 W | 4% |
Conclusion pour nos choix d’IoT
Le Compteur D. sert de référence pour la dynamique fine et pour le bas de plage, là où le S. perd le lien. Le Compteur S. reste utilisable pour l’énergie cumulée, à condition d’appliquer la correction d’offset identifiée en section 7. Étonnamment, le compteur D. est indiqué pour des puissances de plusieurs milliers d’ampères, alors que le compteur S. pour quelques dizaines seulement.
Ce que j’ai appris en menant cette démarche, c’est de ne jamais faire confiance à un capteur unique sans point de comparaison lorsque j’ai le choix. Toujours tester la variabilité sur les incréments et pas seulement sur le signal brut. Enfin, toujours regarder les résidus d’une régression avant de citer son R² global : un chiffre agrégé peut cacher une zone entière où le modèle ne dit plus rien (les fameuses moyennes de moyennes…)
Et vous, la dernière fois que vous avez comparé 2 capteurs, avez-vous regardé plus loin que leur courbe moyenne ? Écrivez-moi pour m’en parler sur LinkedIn ou par mail !
Next steps
Ce protocole en 8 étapes couvre la comparaison statique de 2 capteurs sur une fenêtre fixe. Des méthodes plus avancées restent à explorer, sans qu’elles aient été mises en œuvre ici : une décomposition en ondelettes pour localiser dans le temps où la cohérence décroche, une détection d’événements pour isoler les transitoires de charge où l’écart se creuse le plus, un modèle de transfert pour prédire la lecture du Compteur S. à partir de celle du Compteur D. et le déphasage, ou une détection d’anomalies pour repérer automatiquement une dérive du biais si elle apparaissait sur une fenêtre plus longue. Affaire à suivre…